← Cuba hurricanes AA

11  CHIRPS-GEFS Raster Processing Pipeline

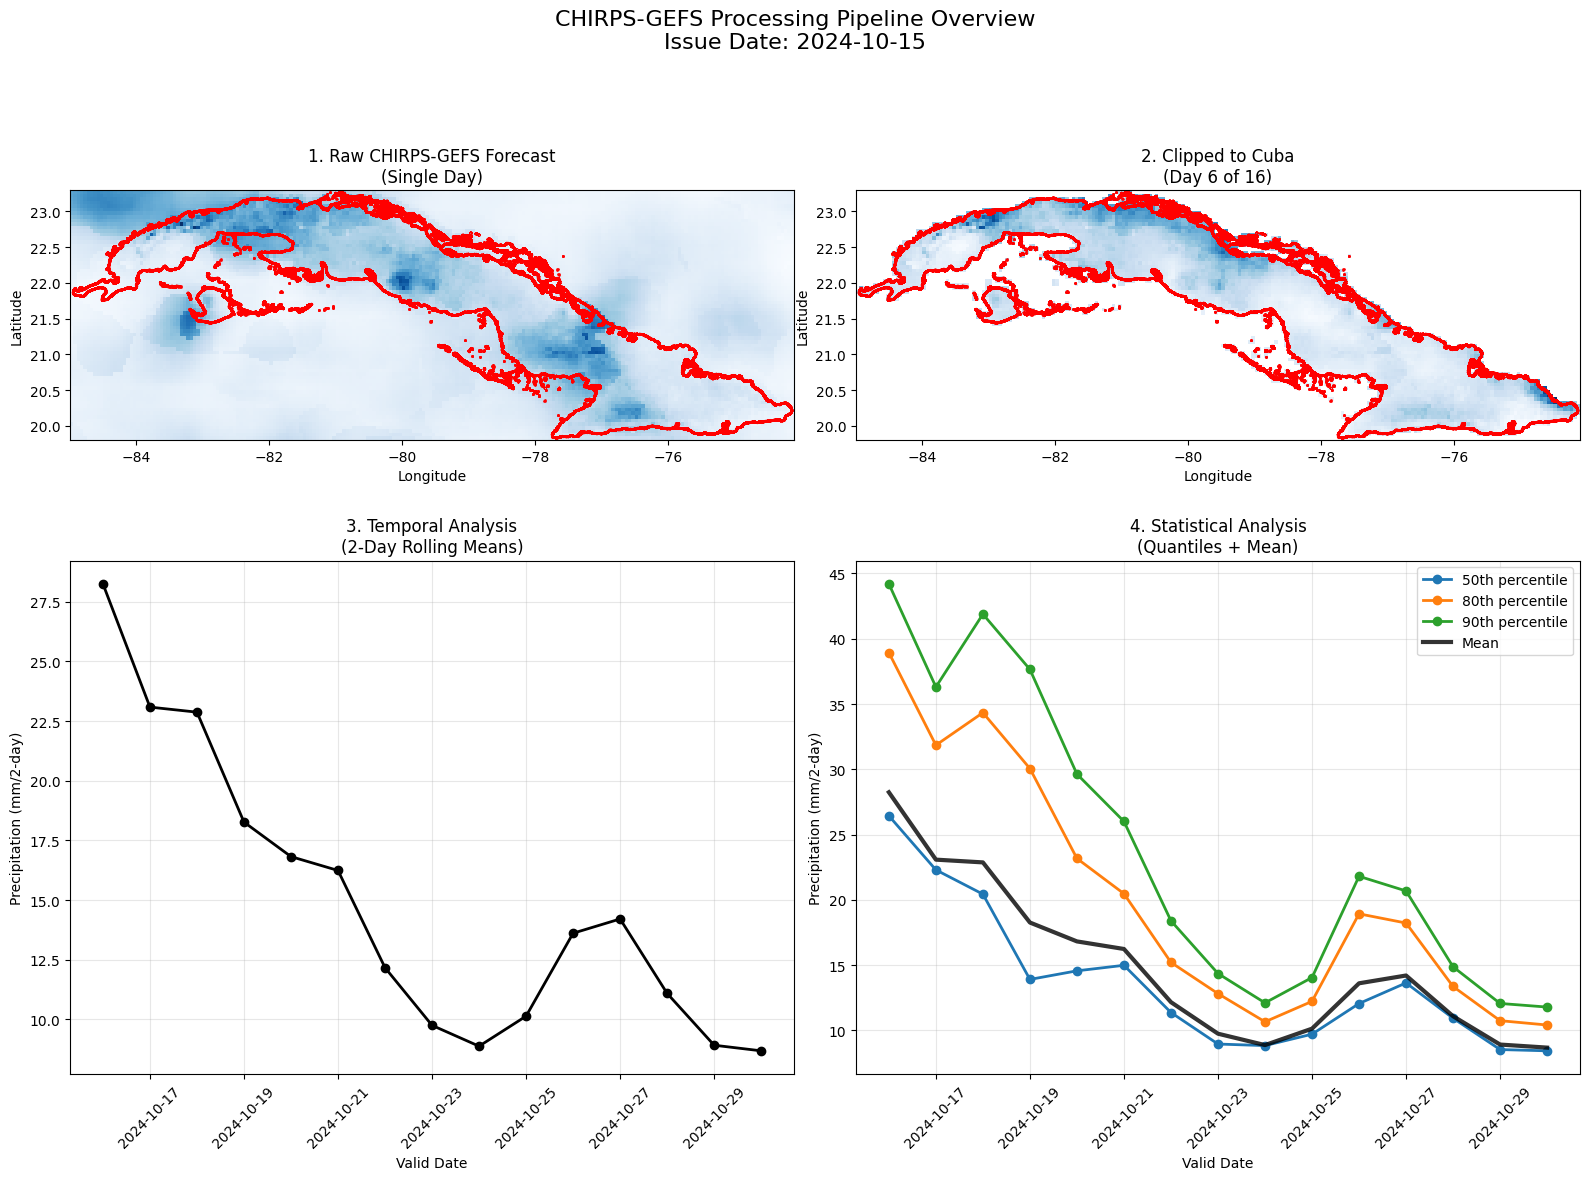
This chapter goes through one iteration of the CHIRPS-GEFS processing loop for a single issue date (15 October 2024):

  1. Load the 16 daily forecasts, one raster per lead time.
  2. Clip them to Cuba’s boundary.
  3. Compute two-day rolling sums.
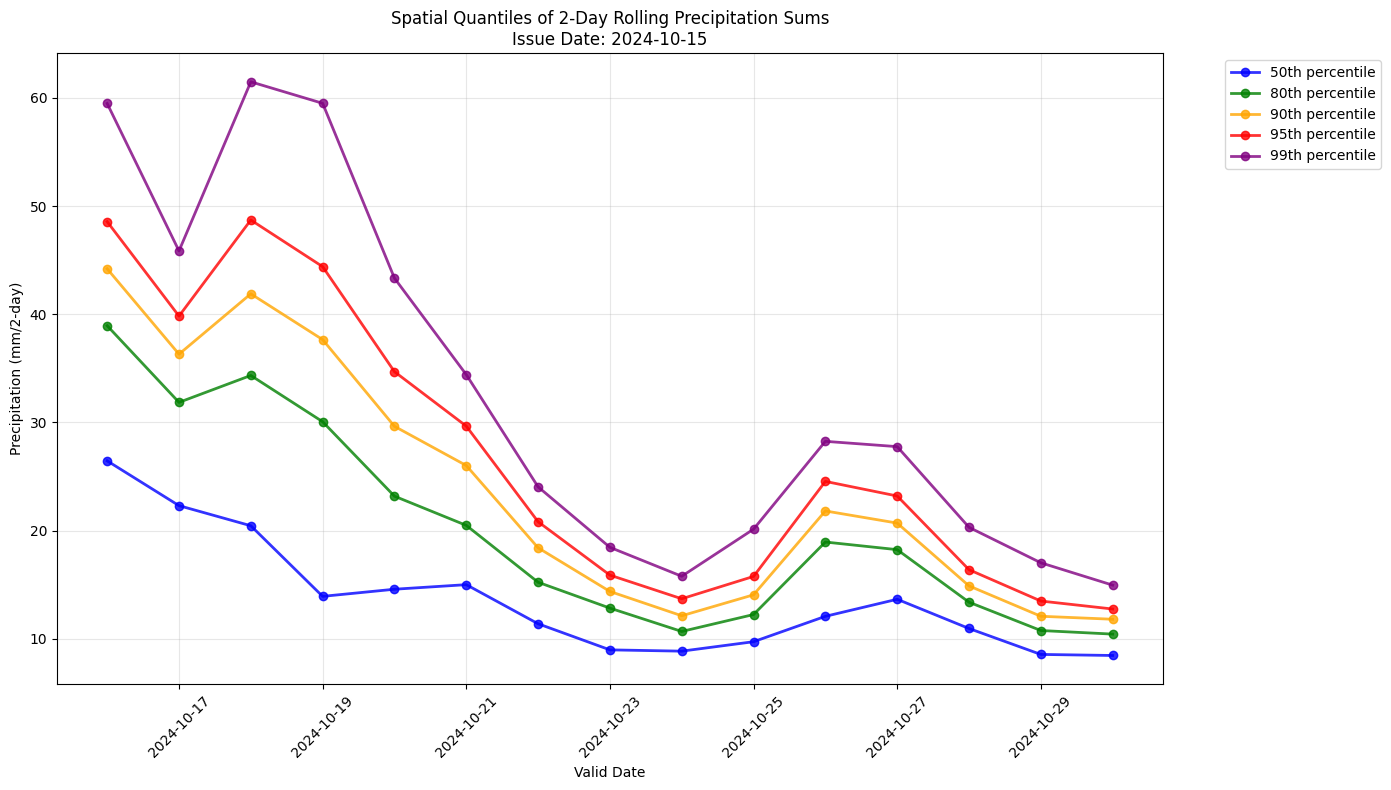
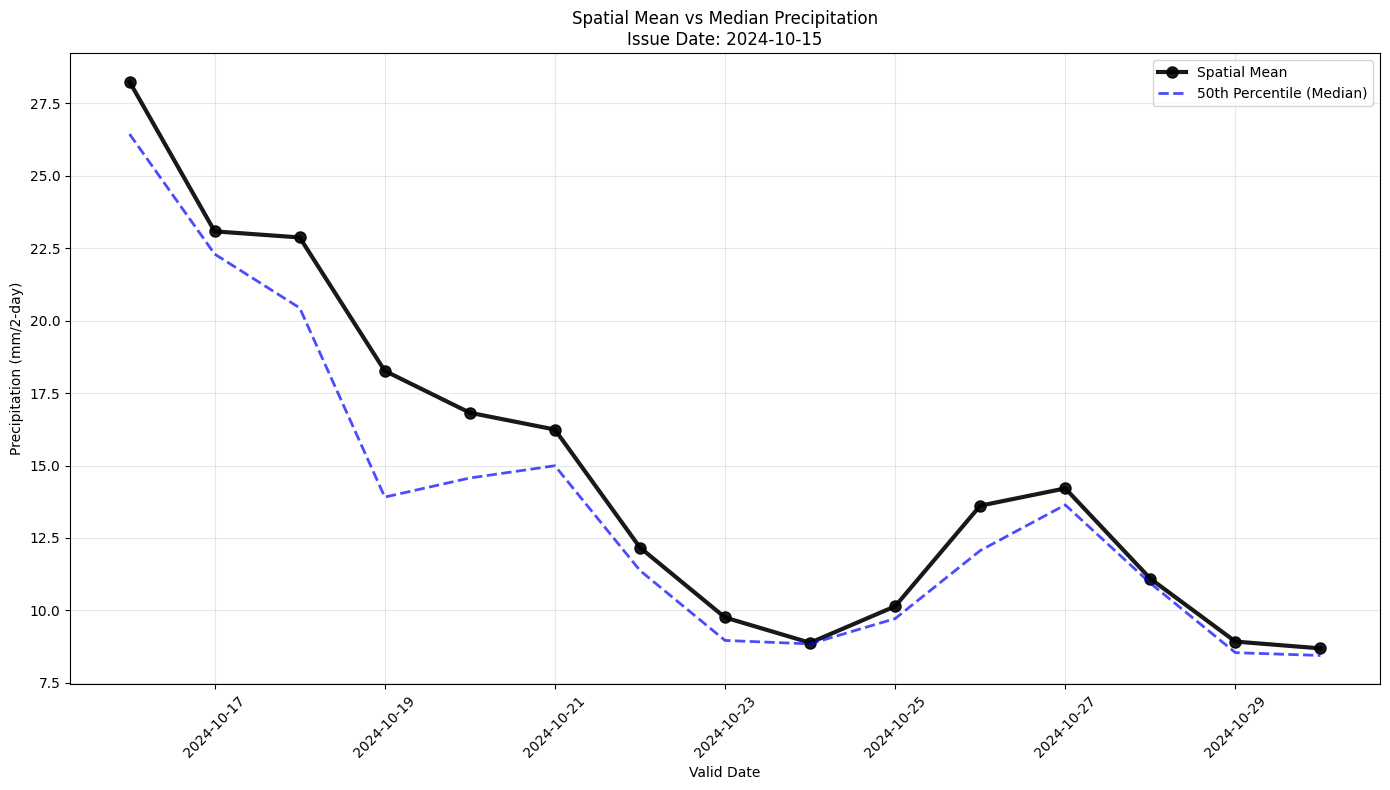
  4. Compute spatial quantiles (50th, 80th, 90th, 95th and 99th percentiles) and the spatial mean of each two-day sum.
  5. Reshape the results into the table format the pipeline writes to the team database.

Nothing is written to the database here. Step 7 only shows what would be stored.

11.1 Setup and Configuration

Code
import pandas as pd
import xarray as xr
import matplotlib.pyplot as plt
import numpy as np
import ocha_stratus as stratus
from azure.core.exceptions import ResourceNotFoundError

from src.datasources.chirps_gefs import ChirpsGefsConfig, ChirpsGefsLoader
from src.datasources import codab
from src.constants import *

# Configure plotting
plt.style.use("default")

# Define table name for database operations
TABLE_NAME = f'{PROJECT_PREFIX.replace("-", "_")}_chirps_gefs'
Code
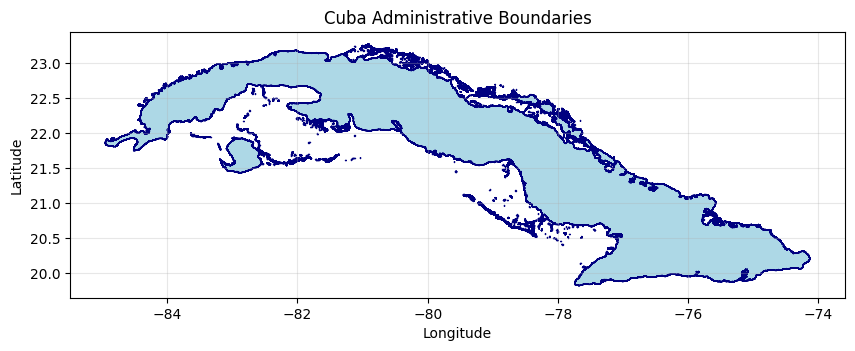
# Load Cuba administrative boundaries
adm0 = codab.load_codab_from_blob()
cuba_bounds = adm0.total_bounds


# Display the geometry
adm0.plot(figsize=(10, 6), color='lightblue', edgecolor='navy')
plt.title('Cuba Administrative Boundaries')
plt.xlabel('Longitude')
plt.ylabel('Latitude')
plt.grid(True, alpha=0.3)
plt.show()

Code
# Initialize CHIRPS-GEFS configuration and loader
config = ChirpsGefsConfig(geometry=adm0, region_name="databricks_run")
loader = ChirpsGefsLoader(config)

11.2 Step 1: Data Loading for Single Issue Date

A lead time with no file in blob storage is reported and skipped.

Code
# Select a specific issue date for demonstration
issue_date = pd.Timestamp("2024-10-15")  # Example issue date

# Load all leadtimes for this issue date (this is one iteration of the main loop)
das_i = []
valid_dates = []
leadtimes_loaded = []

for leadtime in range(config.leadtime_days):
    valid_date = issue_date + pd.Timedelta(days=leadtime)
    valid_dates.append(valid_date)
    
    try:
        # Load individual raster for this leadtime
        da_in = loader.load_raster(issue_date, valid_date)
        da_in["valid_date"] = valid_date
        das_i.append(da_in)
        leadtimes_loaded.append(leadtime)
        
    except ResourceNotFoundError as e:
        print(f"  Missing data for leadtime {leadtime} (valid: {valid_date.strftime('%Y-%m-%d')})")

print(f"\nSuccessfully loaded {len(das_i)} out of {config.leadtime_days} forecasts")
print(f"   Leadtimes loaded: {leadtimes_loaded}")
print(f"   Date range: {valid_dates[0].strftime('%Y-%m-%d')} to {valid_dates[-1].strftime('%Y-%m-%d')}")
Successfully loaded 16 out of 16 forecasts
   Leadtimes loaded: [0, 1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11, 12, 13, 14, 15]
   Date range: 2024-10-15 to 2024-10-30
Code
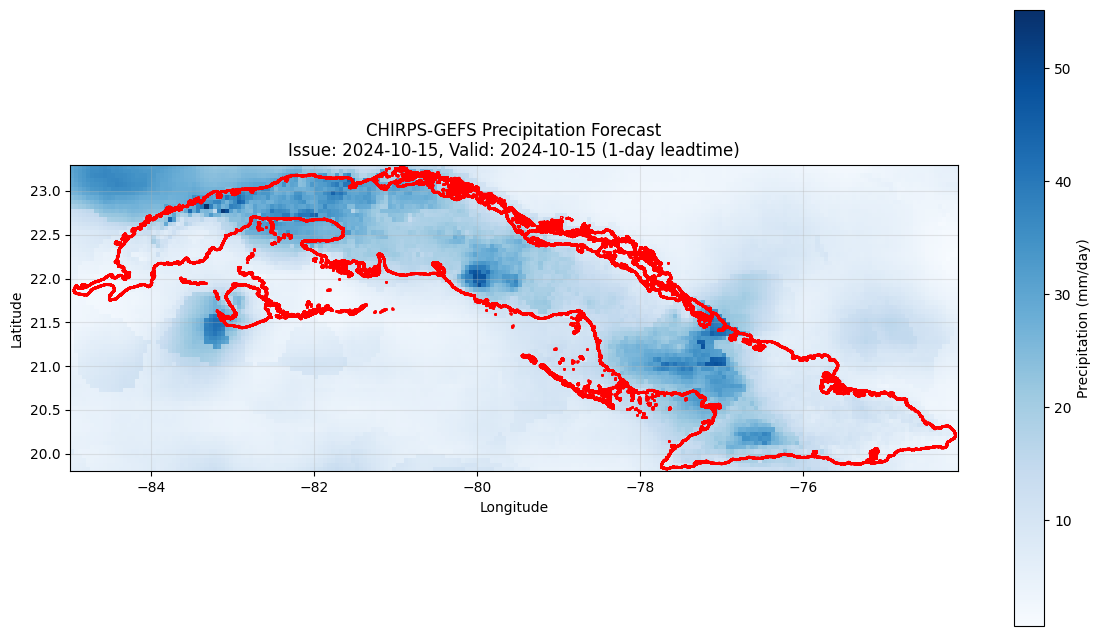
# Examine the structure of a single loaded raster
if das_i:
    sample_raster = das_i[0]  # First leadtime
    
    print(f"Individual Raster Properties:")
    print(f"  Shape: {sample_raster.shape}")
    print(f"  Coordinates: {list(sample_raster.coords.keys())}")
    print(f"  Data range: {sample_raster.min().values:.2f} to {sample_raster.max().values:.2f} mm/day")
    print(f"  CRS: {sample_raster.rio.crs}")
    print(f"  Resolution: {sample_raster.rio.resolution()}")
    
    # Visualize the first forecast day
    fig, ax = plt.subplots(figsize=(12, 8))
    
    # Plot the precipitation data
    im = sample_raster.plot(
        ax=ax,
        cmap='Blues',
        cbar_kwargs={'label': 'Precipitation (mm/day)', 'shrink': 0.8}
    )
    
    # Overlay Cuba boundaries
    adm0.boundary.plot(ax=ax, color='red', linewidth=2)
    
    plt.title(f'CHIRPS-GEFS Precipitation Forecast\n'
              f'Issue: {issue_date.strftime("%Y-%m-%d")}, '
              f'Valid: {valid_dates[0].strftime("%Y-%m-%d")} (1-day leadtime)')
    plt.xlabel('Longitude')
    plt.ylabel('Latitude')
    plt.grid(True, alpha=0.3)
    plt.tight_layout()
    plt.show()
Individual Raster Properties:
  Shape: (70, 218)
  Coordinates: ['x', 'y', 'spatial_ref', 'valid_date']
  Data range: 0.63 to 55.15 mm/day
  CRS: EPSG:4326
  Resolution: (0.05000000074505806, -0.05000000074505806)

11.3 Step 2: Concatenation and Time Series Creation

Code
# Concatenate all leadtimes into a single time series dataset
if das_i:
    
    # This combines all 16 leadtimes into a single xarray Dataset
    da_i = xr.concat(das_i, dim="valid_date")
    
    print(f"Time Series Dataset:")
    print(f"  Shape: {da_i.shape}")
    print(f"  Dimensions: {list(da_i.dims)}")
    print(f"  Valid dates: {len(da_i.valid_date)} days")
    print(f"  Spatial extent: {da_i.x.size} × {da_i.y.size} pixels")
    
    # Show the time series structure
    print(f"\nValid Dates in Time Series:")
    for i, vd in enumerate(da_i.valid_date.values):
        vd_ts = pd.to_datetime(vd)
        leadtime = (vd_ts - issue_date).days
        print(f"  {i+1:2d}. {vd_ts.strftime('%Y-%m-%d')} (leadtime: {leadtime:2d} days)")
Time Series Dataset:
  Shape: (16, 70, 218)
  Dimensions: ['valid_date', 'y', 'x']
  Valid dates: 16 days
  Spatial extent: 218 × 70 pixels

Valid Dates in Time Series:
   1. 2024-10-15 (leadtime:  0 days)
   2. 2024-10-16 (leadtime:  1 days)
   3. 2024-10-17 (leadtime:  2 days)
   4. 2024-10-18 (leadtime:  3 days)
   5. 2024-10-19 (leadtime:  4 days)
   6. 2024-10-20 (leadtime:  5 days)
   7. 2024-10-21 (leadtime:  6 days)
   8. 2024-10-22 (leadtime:  7 days)
   9. 2024-10-23 (leadtime:  8 days)
  10. 2024-10-24 (leadtime:  9 days)
  11. 2024-10-25 (leadtime: 10 days)
  12. 2024-10-26 (leadtime: 11 days)
  13. 2024-10-27 (leadtime: 12 days)
  14. 2024-10-28 (leadtime: 13 days)
  15. 2024-10-29 (leadtime: 14 days)
  16. 2024-10-30 (leadtime: 15 days)
Code
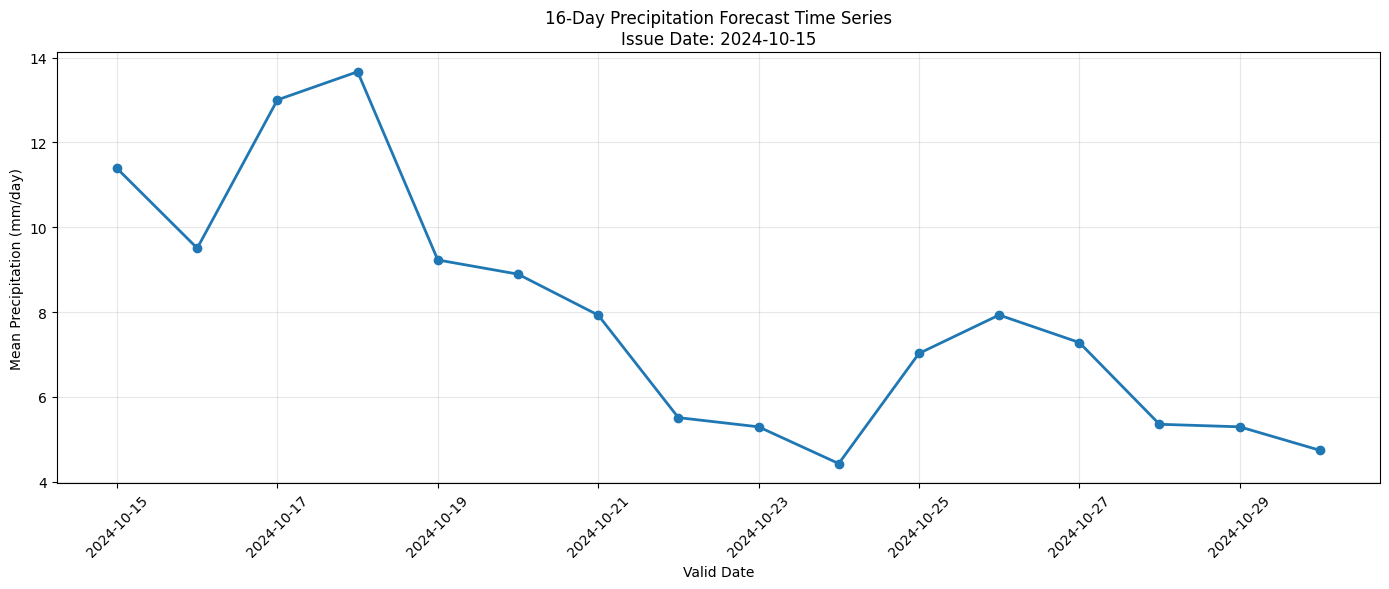
# Visualize the time series structure
if das_i:
    # Calculate daily mean precipitation across Cuba region
    daily_means = da_i.mean(dim=['x', 'y'])
    
    fig, ax = plt.subplots(figsize=(14, 6))
    
    # Plot time series
    valid_dates_dt = pd.to_datetime(da_i.valid_date.values)
    ax.plot(valid_dates_dt, daily_means.values, 'o-', linewidth=2, markersize=6)
    
    ax.set_title(f'16-Day Precipitation Forecast Time Series\n'
                 f'Issue Date: {issue_date.strftime("%Y-%m-%d")}')
    ax.set_xlabel('Valid Date')
    ax.set_ylabel('Mean Precipitation (mm/day)')
    ax.grid(True, alpha=0.3)
    
    # Rotate x-axis labels for better readability
    plt.xticks(rotation=45)
    plt.tight_layout()
    plt.show()
    
    print(f"Time Series Statistics:")
    print(f"  Mean daily precipitation: {daily_means.mean().values:.2f} mm/day")
    print(f"  Maximum daily precipitation: {daily_means.max().values:.2f} mm/day")
    print(f"  Minimum daily precipitation: {daily_means.min().values:.2f} mm/day")

Time Series Statistics:
  Mean daily precipitation: 7.91 mm/day
  Maximum daily precipitation: 13.67 mm/day
  Minimum daily precipitation: 4.43 mm/day

11.4 Step 3: Spatial Clipping to Cuba

Code
# Apply precise spatial clipping to Cuba's boundaries
if das_i:

    # Clip the time series data to Cuba's exact geometry
    da_i_clip = da_i.rio.clip(adm0.geometry, all_touched=True)

    print(f"Spatial Clipping Results:")
    print(f"  Original shape: {da_i.shape}")
    print(f"  Clipped shape: {da_i_clip.shape}")
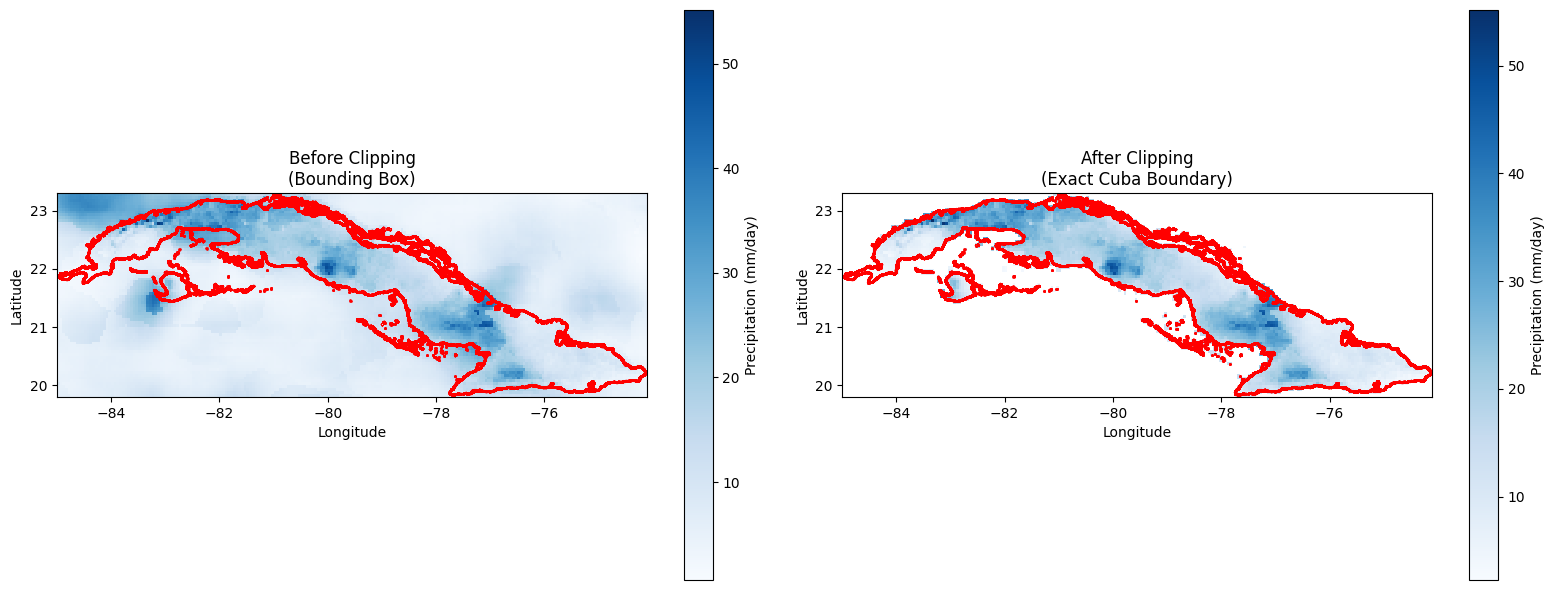
Spatial Clipping Results:
  Original shape: (16, 70, 218)
  Clipped shape: (16, 70, 218)
Code
# Visualize the clipping effect
if das_i:
    fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(16, 6))
    
    # Before clipping
    da_i.isel(valid_date=0).plot(
        ax=ax1,
        cmap='Blues',
        cbar_kwargs={'label': 'Precipitation (mm/day)'}
    )
    adm0.boundary.plot(ax=ax1, color='red', linewidth=2)
    ax1.set_title('Before Clipping\n(Bounding Box)')
    ax1.set_xlabel('Longitude')
    ax1.set_ylabel('Latitude')
    
    # After clipping
    da_i_clip.isel(valid_date=0).plot(
        ax=ax2,
        cmap='Blues',
        cbar_kwargs={'label': 'Precipitation (mm/day)'}
    )
    adm0.boundary.plot(ax=ax2, color='red', linewidth=2)
    ax2.set_title('After Clipping\n(Exact Cuba Boundary)')
    ax2.set_xlabel('Longitude')
    ax2.set_ylabel('Latitude')
    
    plt.tight_layout()
    plt.show()

11.5 Step 4: Temporal Aggregation - 2-Day Rolling Sums

Code
# Create 2-day rolling sums for enhanced precipitation analysis
if das_i:
    
    # Calculate 2-day rolling precipitation sums
    da_rolling2 = da_i_clip.rolling(valid_date=2).sum()
    
    print(f"Rolling Sum Analysis:")
    print(f"  Original time series: {da_i_clip.valid_date.size} days")
    print(f"  Rolling sum series: {da_rolling2.valid_date.size} days")
    print(f"  First valid rolling sum: day 2 (combines days 1-2)")
    
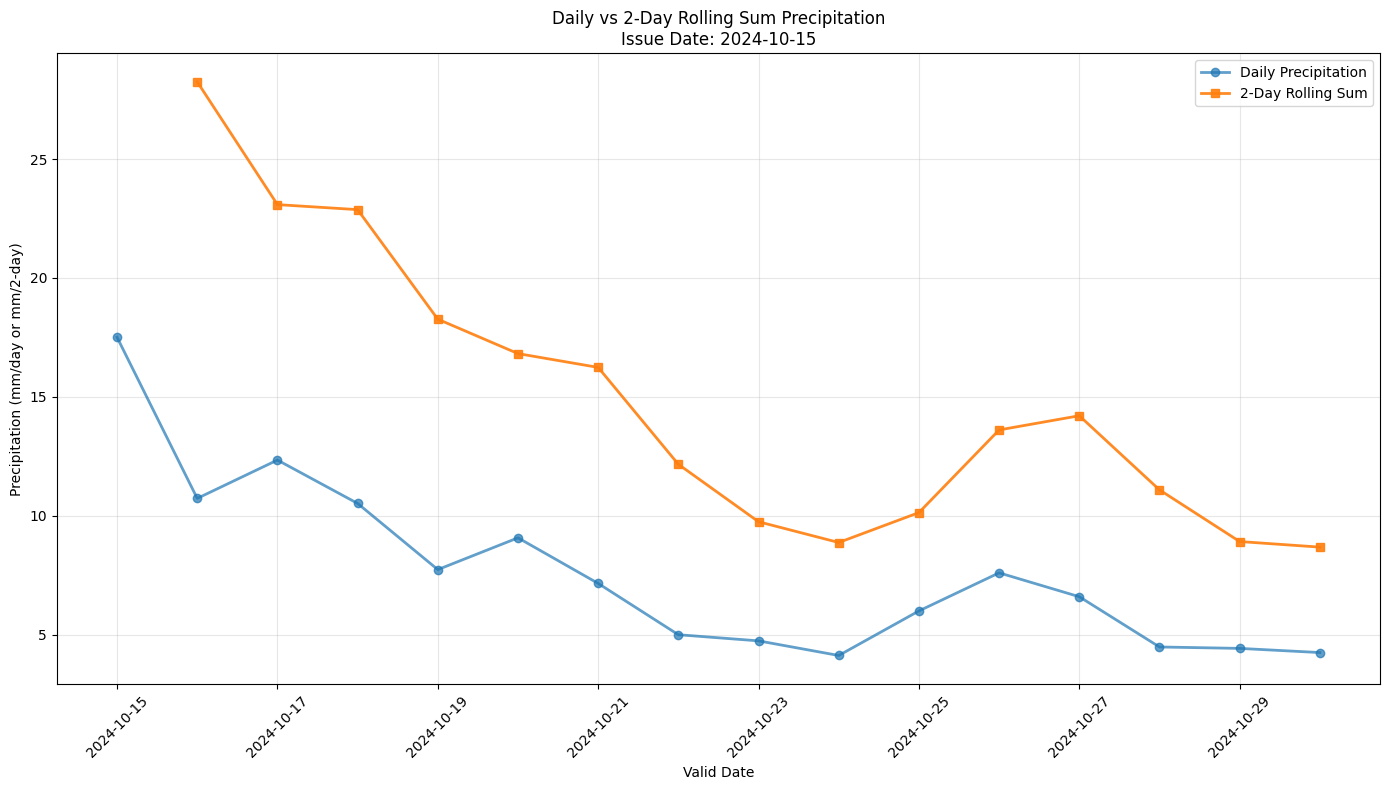
    # Show the effect of rolling sums
    clipped_daily_means = da_i_clip.mean(dim=['x', 'y'])
    rolling_daily_means = da_rolling2.mean(dim=['x', 'y'])
    
    fig, ax = plt.subplots(figsize=(14, 8))
    
    valid_dates_dt = pd.to_datetime(da_i_clip.valid_date.values)
    rolling_dates_dt = pd.to_datetime(da_rolling2.valid_date.values)
    
    # Plot both series
    ax.plot(valid_dates_dt, clipped_daily_means.values, 'o-', 
            label='Daily Precipitation', linewidth=2, alpha=0.7)
    ax.plot(rolling_dates_dt, rolling_daily_means.values, 's-', 
            label='2-Day Rolling Sum', linewidth=2, alpha=0.9)
    
    ax.set_title(f'Daily vs 2-Day Rolling Sum Precipitation\n'
                 f'Issue Date: {issue_date.strftime("%Y-%m-%d")}')
    ax.set_xlabel('Valid Date')
    ax.set_ylabel('Precipitation (mm/day or mm/2-day)')
    ax.legend()
    ax.grid(True, alpha=0.3)
    
    plt.xticks(rotation=45)
    plt.tight_layout()
    plt.show()
    
    print(f"\nRolling Sum Statistics:")
    print(f"  Mean 2-day sum: {rolling_daily_means.mean().values:.2f} mm/2-day")
    print(f"  Maximum 2-day sum: {rolling_daily_means.max().values:.2f} mm/2-day")
Rolling Sum Analysis:
  Original time series: 16 days
  Rolling sum series: 16 days
  First valid rolling sum: day 2 (combines days 1-2)

Rolling Sum Statistics:
  Mean 2-day sum: 14.87 mm/2-day
  Maximum 2-day sum: 28.24 mm/2-day

11.6 Step 5: Quantile Analysis

Code
# Calculate quantiles across space for each time step
if das_i:
    
    # Define quantiles to calculate
    quantiles = [0.5, 0.8, 0.9, 0.95, 0.99]
    
    # Calculate quantiles across space (x, y dimensions) for each time step
    quantile_results = {}
    
    for quantile in quantiles:
        
        # Calculate spatial quantiles for each day
        da_quantile_threshs = da_rolling2.quantile(quantile, dim=["x", "y"])
        quantile_results[quantile] = da_quantile_threshs
        
        print(f"    Shape: {da_quantile_threshs.shape}")
        print(f"    Range: {da_quantile_threshs.min().values:.2f} to {da_quantile_threshs.max().values:.2f} mm/2-day")
    Shape: (16,)
    Range: 8.44 to 26.44 mm/2-day
    Shape: (16,)
    Range: 10.42 to 38.94 mm/2-day
    Shape: (16,)
    Range: 11.79 to 44.20 mm/2-day
    Shape: (16,)
    Range: 12.74 to 48.71 mm/2-day
    Shape: (16,)
    Range: 14.95 to 61.49 mm/2-day
Code
# Visualize quantile progression over time
if das_i and quantile_results:
    fig, ax = plt.subplots(figsize=(14, 8))
    
    colors = ['blue', 'green', 'orange', 'red', 'purple']
    
    for i, (quantile, da_quantile) in enumerate(quantile_results.items()):
        valid_dates_q = pd.to_datetime(da_quantile.valid_date.values)
        
        ax.plot(valid_dates_q, da_quantile.values, 'o-', 
                color=colors[i], label=f'{quantile*100:.0f}th percentile',
                linewidth=2, alpha=0.8)
    
    ax.set_title(f'Spatial Quantiles of 2-Day Rolling Precipitation Sums\n'
                 f'Issue Date: {issue_date.strftime("%Y-%m-%d")}')
    ax.set_xlabel('Valid Date')
    ax.set_ylabel('Precipitation (mm/2-day)')
    ax.legend(bbox_to_anchor=(1.05, 1), loc='upper left')
    ax.grid(True, alpha=0.3)
    
    plt.xticks(rotation=45)
    plt.tight_layout()
    plt.show()
    
    print("Quantile Interpretation:")
    print("  50th percentile: Half of Cuba receives this amount or less")
    print("  80th percentile: 80% of Cuba receives this amount or less") 
    print("  99th percentile: Only 1% of Cuba receives more than this amount")

Quantile Interpretation:
  50th percentile: Half of Cuba receives this amount or less
  80th percentile: 80% of Cuba receives this amount or less
  99th percentile: Only 1% of Cuba receives more than this amount

11.7 Step 6: Spatial Mean Calculation

Code
# Calculate spatial means for each time step
if das_i:
    
    # Calculate mean precipitation across all pixels in Cuba for each day
    da_means = da_rolling2.mean(dim=["x", "y"])
    
    print(f"Spatial Mean Results:")
    print(f"  Time series length: {da_means.valid_date.size} days")
    print(f"  Overall mean: {da_means.mean().values:.2f} mm/2-day")
    print(f"  Standard deviation: {da_means.std().values:.2f} mm/2-day")
    
    # Compare means with quantiles
    fig, ax = plt.subplots(figsize=(14, 8))
    
    valid_dates_mean = pd.to_datetime(da_means.valid_date.values)
    
    # Plot spatial mean
    ax.plot(valid_dates_mean, da_means.values, 'ko-', 
            linewidth=3, markersize=8, label='Spatial Mean', alpha=0.9)
    
    # Add 50th percentile (median) for comparison
    if 0.5 in quantile_results:
        q50 = quantile_results[0.5]
        ax.plot(pd.to_datetime(q50.valid_date.values), q50.values, 'b--', 
                linewidth=2, label='50th Percentile (Median)', alpha=0.7)
    
    ax.set_title(f'Spatial Mean vs Median Precipitation\n'
                 f'Issue Date: {issue_date.strftime("%Y-%m-%d")}')
    ax.set_xlabel('Valid Date')
    ax.set_ylabel('Precipitation (mm/2-day)')
    ax.legend()
    ax.grid(True, alpha=0.3)
    
    plt.xticks(rotation=45)
    plt.tight_layout()
    plt.show()
Spatial Mean Results:
  Time series length: 16 days
  Overall mean: 14.87 mm/2-day
  Standard deviation: 5.83 mm/2-day

11.8 Step 7: Data Preparation for Database Storage

Code
# Transform quantile data into database format
if das_i and quantile_results:
    
    # Demonstrate data transformation for quantiles
    sample_quantile = 0.8  # 80th percentile
    da_sample_quantile = quantile_results[sample_quantile]
    
    # Convert to DataFrame (this is what happens in the actual pipeline)
    df_quantile_sample = (
        da_sample_quantile.to_dataframe("value")
        .reset_index()
        .drop(columns="quantile")
    )
    df_quantile_sample["variable"] = f"q{sample_quantile*100:.0f}"
    df_quantile_sample["issued_date"] = issue_date
    
    print(f"Sample Quantile DataFrame (80th percentile):")
    print(f"  Shape: {df_quantile_sample.shape}")
    print(f"  Columns: {list(df_quantile_sample.columns)}")
    print("\nFirst 5 rows:")
    display(df_quantile_sample.head())
    
    # Demonstrate data transformation for means
    df_means_sample = (
        da_means.to_dataframe("value")
        .reset_index()
        .drop(columns="spatial_ref")
    )
    df_means_sample["variable"] = "mean"
    df_means_sample["issued_date"] = issue_date
    
    print(f"\nSample Means DataFrame:")
    print(f"  Shape: {df_means_sample.shape}")
    print(f"  Columns: {list(df_means_sample.columns)}")
    print("\nFirst 5 rows:")
    display(df_means_sample.head())
Sample Quantile DataFrame (80th percentile):
  Shape: (16, 4)
  Columns: ['valid_date', 'value', 'variable', 'issued_date']

First 5 rows:
valid_date value variable issued_date
0 2024-10-15 NaN q80 2024-10-15
1 2024-10-16 38.935509 q80 2024-10-15
2 2024-10-17 31.848692 q80 2024-10-15
3 2024-10-18 34.337166 q80 2024-10-15
4 2024-10-19 30.059734 q80 2024-10-15
Sample Means DataFrame:
  Shape: (16, 4)
  Columns: ['valid_date', 'value', 'variable', 'issued_date']

First 5 rows:
valid_date value variable issued_date
0 2024-10-15 NaN mean 2024-10-15
1 2024-10-16 28.244272 mean 2024-10-15
2 2024-10-17 23.083252 mean 2024-10-15
3 2024-10-18 22.871956 mean 2024-10-15
4 2024-10-19 18.267683 mean 2024-10-15
Code
# Show the complete data structure that would be stored
if das_i and quantile_results:
    print("Complete Database Records for One Issue Date:")
    
    # Count total records that would be created
    total_records = 0
    
    # Quantile records
    for quantile in quantiles:
        da_q = quantile_results[quantile]
        records_per_quantile = len(da_q.valid_date)
        total_records += records_per_quantile
        print(f"  {quantile*100:4.0f}th percentile: {records_per_quantile:2d} records")
    
    # Mean records
    mean_records = len(da_means.valid_date)
    total_records += mean_records
    print(f"  Spatial means:      {mean_records:2d} records")
    
    print(f"\n  Total records: {total_records} for issue date {issue_date.strftime('%Y-%m-%d')}")
    
    # Show database schema
    print(f"\nDatabase Schema (table: projects.{TABLE_NAME}):")
    print("  ┌─────────────┬──────────┬─────────────────────────────────┐")
    print("  │ Column      │ Type     │ Description                     │")
    print("  ├─────────────┼──────────┼─────────────────────────────────┤")
    print("  │ valid_date  │ Date     │ Date forecast is valid for      │")
    print("  │ issued_date │ Date     │ Date forecast was issued        │")
    print("  │ variable    │ Text     │ Statistic type (q50, q80, mean)│")
    print("  │ value       │ Real     │ Precipitation value (mm/2-day)  │")
    print("  └─────────────┴──────────┴─────────────────────────────────┘")
Complete Database Records for One Issue Date:
    50th percentile: 16 records
    80th percentile: 16 records
    90th percentile: 16 records
    95th percentile: 16 records
    99th percentile: 16 records
  Spatial means:      16 records

  Total records: 96 for issue date 2024-10-15

Database Schema (table: projects.ds_aa_cub_hurricanes_chirps_gefs):
  ┌─────────────┬──────────┬─────────────────────────────────┐
  │ Column      │ Type     │ Description                     │
  ├─────────────┼──────────┼─────────────────────────────────┤
  │ valid_date  │ Date     │ Date forecast is valid for      │
  │ issued_date │ Date     │ Date forecast was issued        │
  │ variable    │ Text     │ Statistic type (q50, q80, mean)│
  │ value       │ Real     │ Precipitation value (mm/2-day)  │
  └─────────────┴──────────┴─────────────────────────────────┘

11.9 Summary: Complete Processing Pipeline

Code
# Summary visualization showing the complete pipeline
if das_i:
    fig, axes = plt.subplots(2, 2, figsize=(16, 12))
    
    # 1. Raw precipitation forecast (top-left)
    sample_raster.plot(ax=axes[0,0], cmap='Blues', add_colorbar=False)
    adm0.boundary.plot(ax=axes[0,0], color='red', linewidth=2)
    axes[0,0].set_title('1. Raw CHIRPS-GEFS Forecast\n(Single Day)')
    axes[0,0].set_xlabel('Longitude')
    axes[0,0].set_ylabel('Latitude')
    
    # 2. Clipped time series (top-right)
    da_i_clip.isel(valid_date=5).plot(ax=axes[0,1], cmap='Blues', add_colorbar=False)
    adm0.boundary.plot(ax=axes[0,1], color='red', linewidth=2)
    axes[0,1].set_title('2. Clipped to Cuba\n(Day 6 of 16)')
    axes[0,1].set_xlabel('Longitude')
    axes[0,1].set_ylabel('Latitude')
    
    # 3. Time series analysis (bottom-left)
    valid_dates_dt = pd.to_datetime(da_means.valid_date.values)
    axes[1,0].plot(valid_dates_dt, da_means.values, 'ko-', linewidth=2)
    axes[1,0].set_title('3. Temporal Analysis\n(2-Day Rolling Means)')
    axes[1,0].set_xlabel('Valid Date')
    axes[1,0].set_ylabel('Precipitation (mm/2-day)')
    axes[1,0].grid(True, alpha=0.3)
    axes[1,0].tick_params(axis='x', rotation=45)
    
    # 4. Statistical distribution (bottom-right)
    for i, (quantile, da_quantile) in enumerate(list(quantile_results.items())[:3]):
        valid_dates_q = pd.to_datetime(da_quantile.valid_date.values)
        axes[1,1].plot(valid_dates_q, da_quantile.values, 'o-', 
                      label=f'{quantile*100:.0f}th percentile', linewidth=2)
    axes[1,1].plot(valid_dates_dt, da_means.values, 'k-', 
                   label='Mean', linewidth=3, alpha=0.8)
    axes[1,1].set_title('4. Statistical Analysis\n(Quantiles + Mean)')
    axes[1,1].set_xlabel('Valid Date')
    axes[1,1].set_ylabel('Precipitation (mm/2-day)')
    axes[1,1].legend()
    axes[1,1].grid(True, alpha=0.3)
    axes[1,1].tick_params(axis='x', rotation=45)
    
    plt.suptitle(f'CHIRPS-GEFS Processing Pipeline Overview\nIssue Date: {issue_date.strftime("%Y-%m-%d")}', 
                 fontsize=16, y=0.98)
    plt.tight_layout()
    plt.show()
11.10 Output

For each issue date and valid date the pipeline stores six statistics of the two-day sum: the five quantiles and the mean. The first valid date has no two-day sum, because the sum needs the day before. The trigger uses the 80th percentile (q80).